Foglald össze ezt a cikket
Kattints a kedvenc AI eszközödre a gyors összefoglalóért:
Egyik első freelance SEO projektem egy Node.js technológiával foglalkozó startup volt. Akkor ragadt rám egy kevés Node.js-es tudás, aminek most nagy hasznát vettem egy saját hobbiprojekt során.
Többször előfordult már, hogy egy weboldal indexeltségi állapotát akartam ellenőrizni, de akadályokba ütköztem.
A fő probléma, hogy a Google Search Console csak limitáltan használható erre:
- csak egyesével lehet URL-eleket lekérni
- max napi 200 URL-es limit van egy hitelesített fiókon
- a Coverage Report pedig csak 1000 URL-t enged letölteni, többet nem
Vagyis ha szeretném nagyon sok (pl 5-1000 ezer) URL indexeltségi állapotát lekérni, vagy gyorsan kell 15 konkrét URL, akkor a Search Console webes felülete nem lesz jó megoldás.

Miért akarna bárki ilyet csinálni, hogy indexeltségi állapotot kér le?
A válasz egyszerű: az a tartalom, ami nincs indexelve, az biztosan nem is jelenik meg a Google keresések során.
Tehát hiába van egy URL mondjuk:
- benne a sitemapben
- dob 200-as response kódot
- járt is rajta a Google, mert mondjuk ezt látom log fájlokban
- de mégsem jelenik meg a keresési találatok során.
A keresési találatban való megjelenéshez ugyanis két lépés mindenképp kell:
- a crawler (Googlebot) járjon az adott tartalmon (ezt látom szerver log fájlokból)
- és indexelje is azt (ezt látom Search Consoleban, de csak limitáltan)
A jó hír, hogy vannak olyan megoldások, amivel ezt az utóbbi problémát is fel lehet oldani. Itt jön képbe a múlt heti Brighton SEO konferencia és a Node.js tudás.
A SEO automatizációról szóló előadásom mellett egy panelbeszélgetést is moderáltam, ahol a „technical SEO, indexation, robots.txt and log file analysis” voltak a fő témák.

Itt mesélt Jose Hernando (középen) arról a megoldásról, amit ők maguk is használnak cégen belül az indexelés ellenőrzésére.
Néhány script, egy API és Node.js segítségével le lehet kérni, hogy egy URL indexelt-e vagy sem. Akár nagy tételben.
Google Indexation Checker
Első lépésként npm-et és git-et kell telepíteni + egy Visual Studio Code-ot (vagy ki mit preferál). Utána git repot kell klónozni, megadni azokat a URL-eket, amiket ellenőrizni akarunk, beállítani egy Scraper API-t és végül futtatni az egész kódot.
És a végeredmény? Amit itt lent is látni lehet:
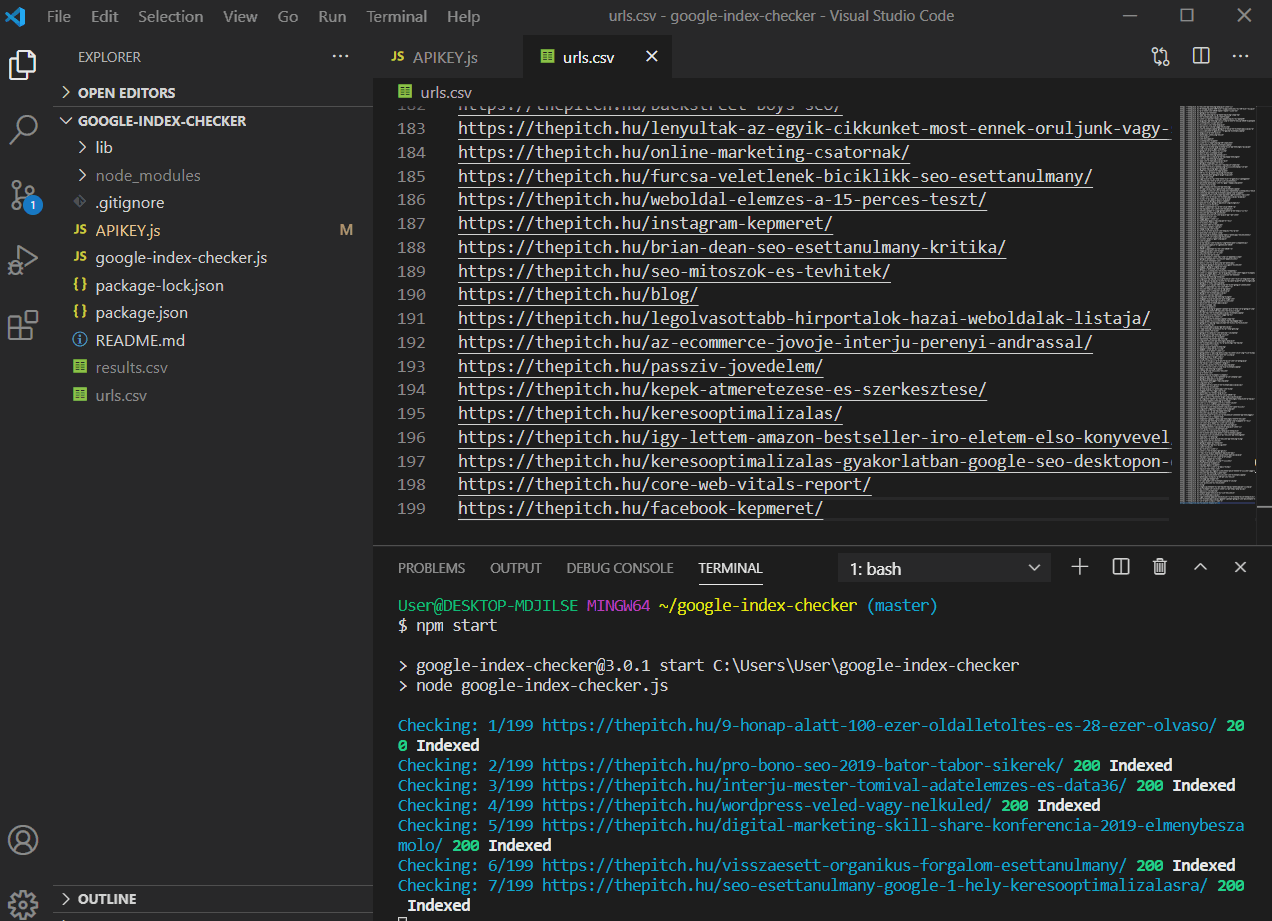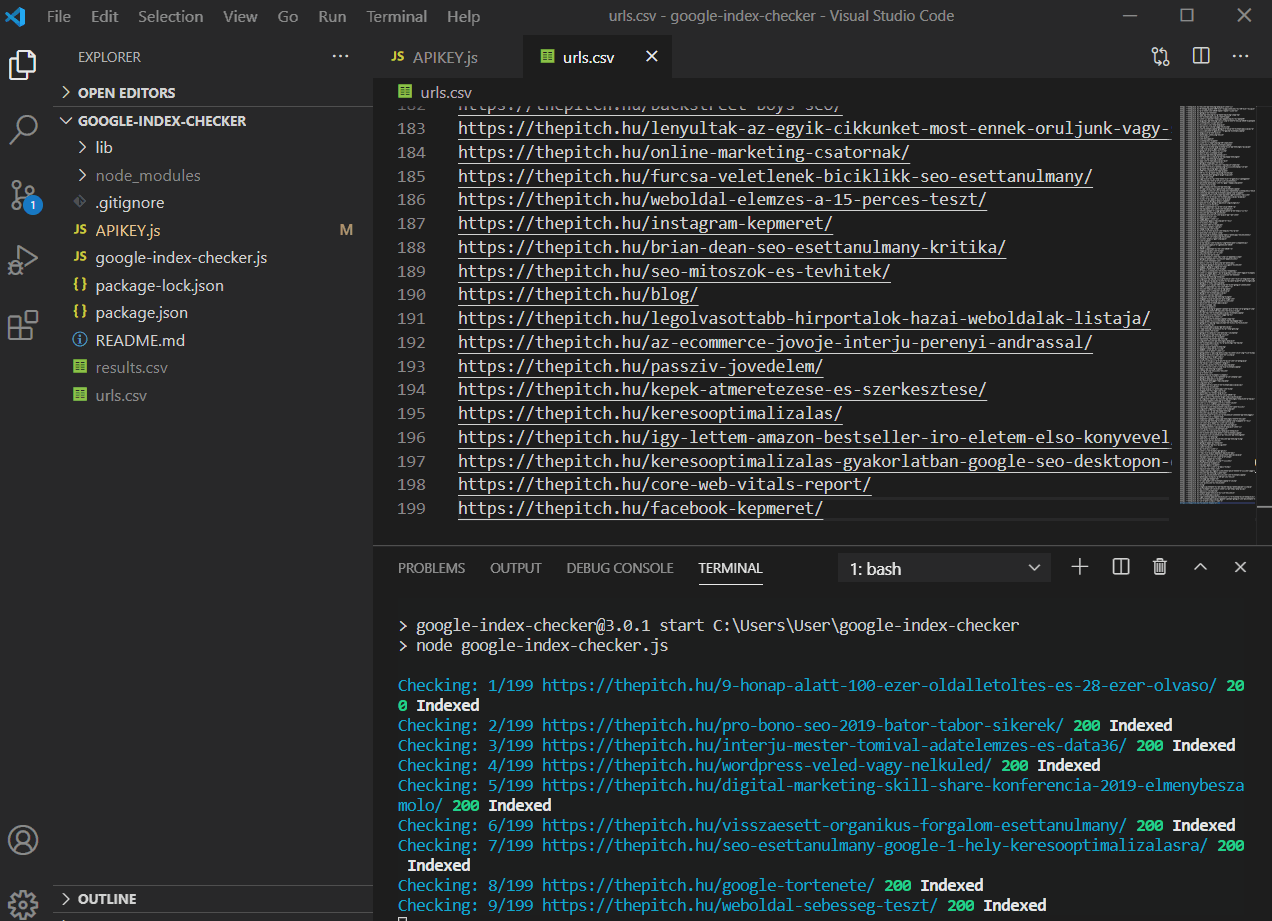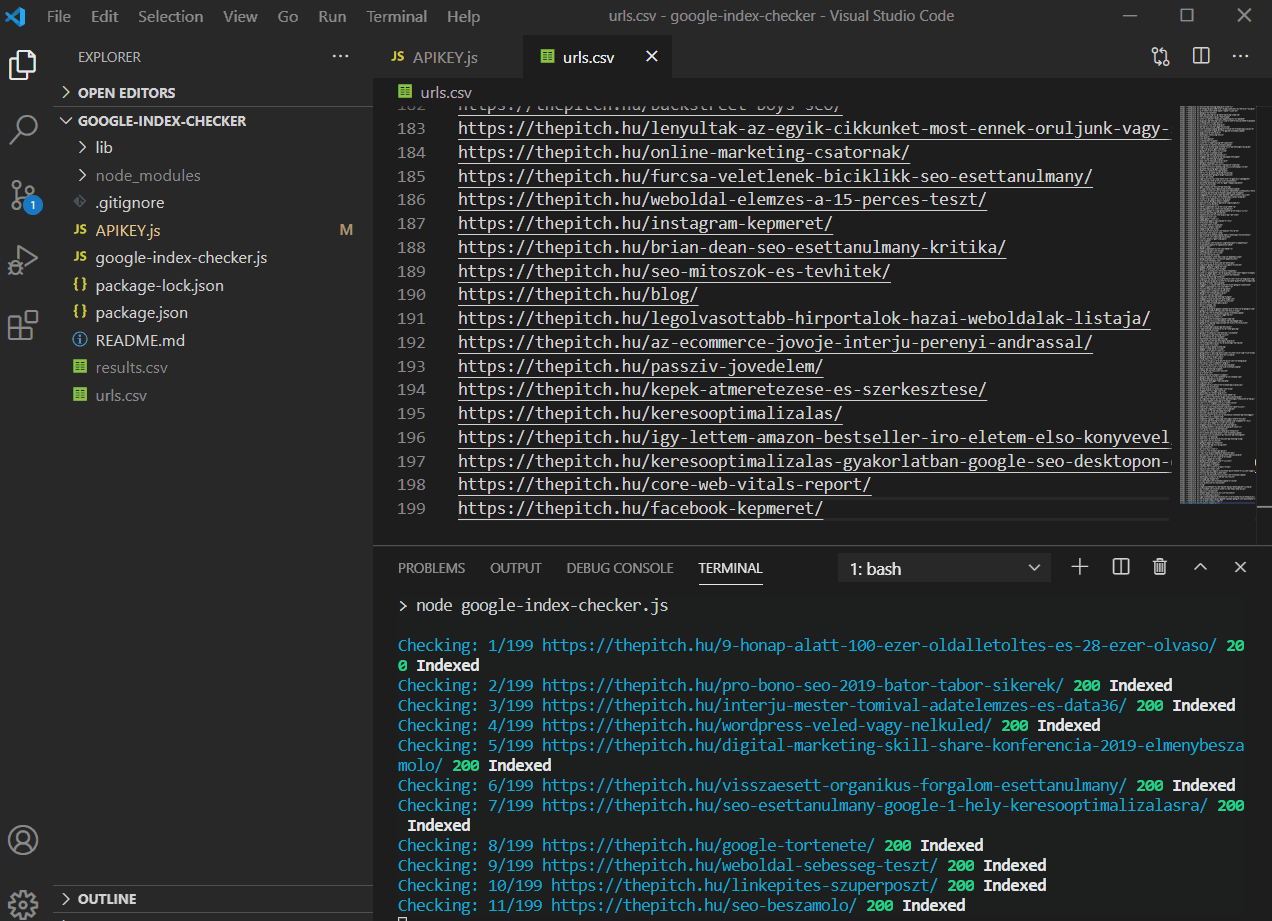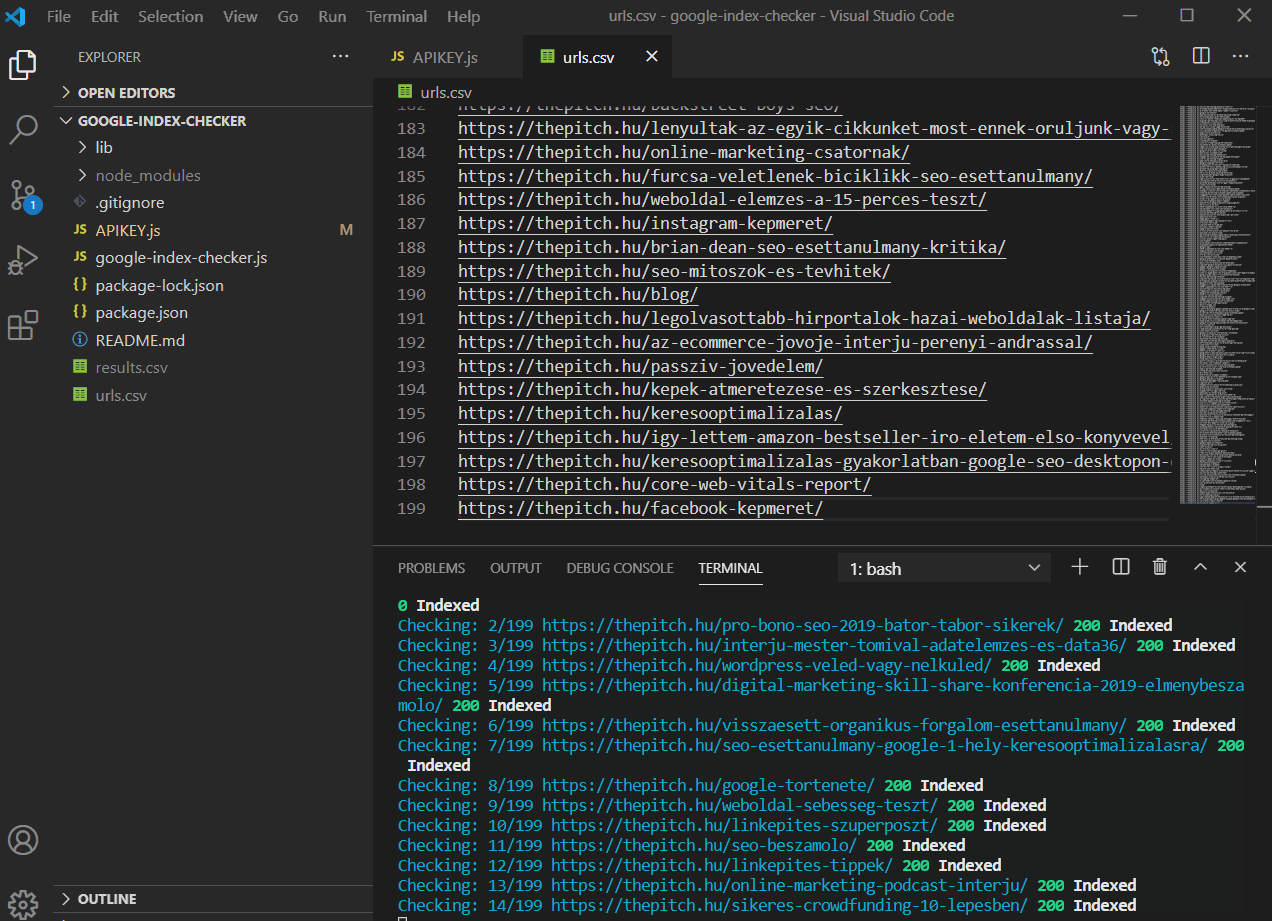
A program végigmegy azokon az URL-eken, amiket megadok nekik és 2 fontos dolgot ad vissza alul:
- indexelt az adott URL
- vagy sem!
Itt például az látható, hogy a The Pitch sitemapben lévő 199 blogposztjából 198 indexált. 1 viszont nem. Ez utóbbi egy alacsony szám, ugyanakkor mégis fura, hogy van olyan tartalom, amin járt a Google többször is, most jelenleg nincs benne az indexében. Tehát keresések során nem is szolgálja ki ezt.

Innentől kezdve pedig ellenőrizni lehet, hogy az adott URL-lel mi a probléma? Látja a Google? Ha igen és járt rajta, akkor miért nem indexeli?
Hol lehet hasznos ez az eszköz?
- Hol van probléma az oldalfelépítésével, architektúrájával?
- Van-e olyan része az oldalnak, amit feleslegesen indexel? Ezzel akár potenciálisan crawl budgetet vesztegetünk el? (bár ez inkább csak nagy oldalak esetében jelenik meg)
- Régi, megszűnt oldalak tényleg eltűntek az indexből?
- Kiszolgálunk-e esetleg 404-es hibaoldalt a Google találatok során?
- Mennyire egészséges egy sitemap? Hány százaléka van a sitemapnek indexelve?
- A Googlebot által vizsgált URL-ek közül mennyit indexel tényleg?
- Egy weboldal migráció után ellenőrizni akarod, hogy a régi URL-ek eltűntek-e már a Google találatok közül és az újak megjelentek-e?
- Indexel a Google „non-canonical” URL-eket? Ha igen, mi az oka és hogy tudjuk javítani?
A megoldás persze alkalmas valós idejű indexing tesztelésére is például nagyobb hírportáloknál, faceted navigation crawling problémák ellenőrzésére webshopoknál, régi 404-es oldalak deindexelésére, és így tovább.
Általánosan elmondható viszont, hogy minél nagyobb egy oldal, ennek a módszernek és eszköznek annál nagyobb haszna van.
Ha valaki egy 20-30 oldalból álló blogot visz, akkor nem ez az eszköz, ahova elsőként rohanni érdemes, mert ott a Google Search Console elég adatot tud majd biztosítani.
Viszont ahol több ezer, tízezer vagy százezres nagyságrendű oldalakról, webshopokról van szó, ott a Google Indexing ellenőrzése egy hasznos eszköz.
Főként azért, mert elsősorban nagy oldalak esetében fordul elő az, hogy relatív alacsony a crawl ratio és az active ration is.
A crawl ratio azt mutatja meg, hogy egy adott weboldal összes URL-je közül hány százalékon járt a Googlebot az elmúlt 30 napban. Ha van 1.000 URL és ebből 780 URL-en járt, akkor a crawl ratio itt 78% lesz.
Az active ratio pedig azt mutatja meg, hogy az oldalak hány százalékán volt legalább 1 organikus kattintás.
Minél nagyobb egy oldal, jellemzően a crawl ratio és az active ratio is annál kisebb.

Vagyis minél nagyobb egy oldal, annál fontosabb lesz látnunk, hogy indexing téren mi történik pontosan.
Jelen pillanatban viszont a Google nem ad olyan eszközt, amivel ezt egy átlag felhasználó is ellenőrizni tudná nagy tételben.
Csak a Google Indexing API-t lehet erre használni. Ehhez viszont szükség van valamilyen egyéb eszközre / programra is, amivel ki lehet nyerni az adatokat. Például a Node.js-re és hány scriptre, ahogy a fenti példában is láthattuk.
Ezzel a cikkel pedig megnyitottam egy új kategóriát a blogon „Technikai SEO” néven. Mostantól ide (is) fogom feltenni azokat a cikkeket, amik elsősorban technikai megoldások iránt érdeklődőknek szól:
2015 óta vezetem a The Pitch szakmai munkáját, a csapattal évente több mint száz ügyfélnek segítünk. Egyik szakmai szervezője vagyok a Digital Cube Confnak, az ország legnagyobb analitika, PPC és SEO konferenciájának. A képzésen azt adom át, ami az ügyfélmunkában tényleg működik.
Papp Gábor cikkei

